운영 중인 JVM 서비스의 태스크가 하나씩 종료되기 시작했어요. EC2 호스트의 메모리는 여유가 있어 보였어요. 정해 둔 태스크 수를 유지하려고 ECS 서비스가 새 태스크를 띄웠지만, 그 안의 앱 컨테이너도 오래 버티지 못했어요.
처음에는 태스크에 배정한 메모리를 늘렸어요. 그래도 OOM이 다시 발생했어요. 뒤늦게 확인한 것은 메모리 양보다 JVM이 힙 크기를 계산할 때 사용한 기준이었어요.
우리가 쓰던 ECS on EC2
당시에는 ECS on EC2를 쓰고 있었어요. 뒤의 이야기에 필요한 관계만 먼저 정리해 볼게요.
- EC2 인스턴스는 태스크가 실행되는 서버예요. 이 서버의 CPU와 RAM을 태스크가 사용해요.
- ECS 서비스는 정해 둔 개수만큼 태스크가 실행되도록 유지해요. 태스크 하나가 종료되면 새 태스크를 띄워 그 수를 채워요.
- 태스크 정의는 컨테이너 이미지와 메모리 한도 등을 적어 둔 실행 설정이에요. 그 정의로 실제 실행된 한 단위가 태스크예요.
- 태스크 안의 앱 컨테이너에서 JVM이 실행돼요. 태스크 전체와 컨테이너 각각에 메모리 한도를 둘 수 있어요.
여기서 중요한 것은 EC2의 RAM과 태스크의 메모리 한도가 서로 다른 경계라는 점이에요. EC2 전체에 여유가 있어도 한 태스크가 자기 한도에 닿으면 종료될 수 있어요. 서비스가 대체 태스크를 띄워도 메모리 설정은 그대로예요.
ECS의 구성과 설정을 더 알고 싶다면 AWS의 ECS 서비스 설명과 태스크 정의의 메모리 설정을 참고해 주세요.
호스트는 여유로워 보였는데, 태스크는 죽었다
당시 모니터링에서 EC2 전체 메모리가 꽉 찬 모습은 아니었어요. 반면 사고 구간의 ECS 메모리 사용률은 한도에 거의 닿았고, ECS는 여러 태스크의 종료 이유를 메모리 초과와 exit 137로 기록했어요. 관측 지표의 범위가 달랐던 거죠.
처음에는 두 태스크가 요청을 처리하고 있었어요. 한 태스크가 죽자 서비스는 대체 태스크를 띄웠지만, 다른 태스크와 대체 태스크도 연이어 종료됐어요. 태스크가 빠질 때마다 남은 태스크가 요청을 받아야 해서 대응이 더 어려워졌어요.
이후 CPU 경보에 연결된 오토스케일링 정책이 작동해 태스크 수가 더 늘었고, 서비스는 잠시 안정을 찾았어요. 그 사이 태스크 메모리 한도도 늘려 봤고, EC2 인스턴스 유형도 더 큰 것으로 바꿨어요. 하지만 호스트를 키운 뒤에도 OOM이 다시 났어요. 태스크를 더 띄우거나 호스트를 키우는 대응만으로는 각 태스크의 메모리 설정 문제가 해결되지 않았던 거예요.
비율은 설정했지만, 기준을 확인하지 않았다
JVM에는 이미 -XX:MaxRAMPercentage가 설정돼 있었어요. JVM이 인식한 메모리 중 최대 힙에 사용할 비율을 정하는 옵션이에요. 저는 그 비율이 태스크 메모리 한도에 적용될 거라고 생각했어요. 하지만 당시에는 태스크 전체 한도만 있고 앱 컨테이너의 하드 한도는 비어 있었어요.
가상 예시: 호스트 4GiB, 태스크 한도 2GiB
가령 메모리 4GiB인 EC2 위에서 태스크 한도를 2GiB로 두고 힙 비율을 70%로 설정했다고 해 볼게요. 태스크 한도를 기준으로 계산한다면 최대 힙은 1.4GiB여야 해요. 그런데 JVM이 호스트 메모리 4GiB를 기준으로 계산한다면 최대 힙은 2.8GiB가 돼요. 힙의 실제 사용량과 무관하게, 힙을 키울 수 있는 상한부터 태스크 한도 2GiB를 넘는 셈이에요.
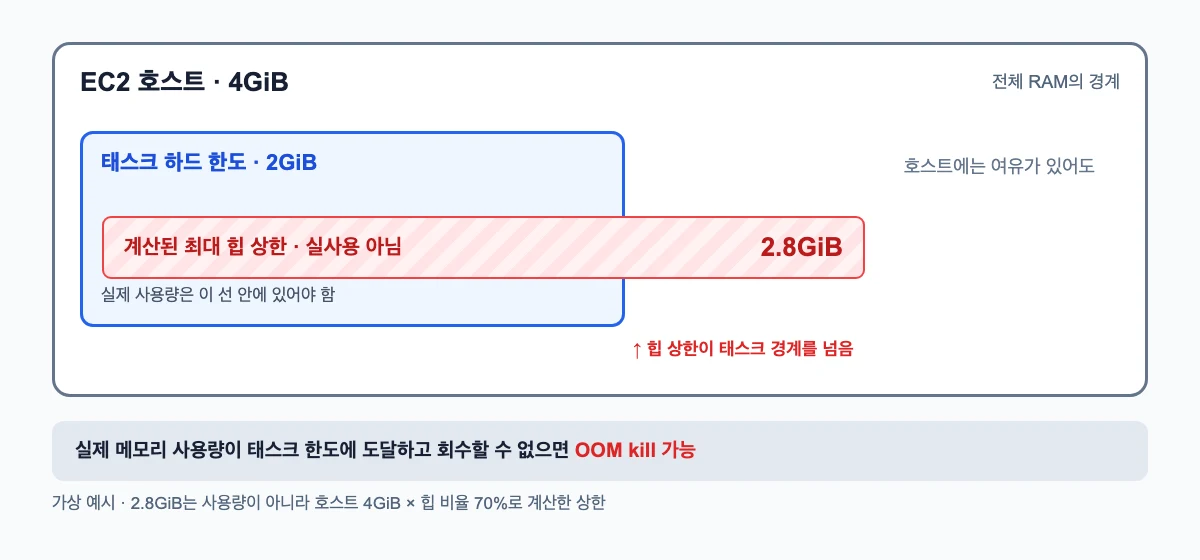
빨간 막대는 실제로 2.8GiB를 점유했다는 뜻이 아니에요. JVM이 힙을 그만큼 키울 수 있다고 계산한 최대 상한이에요. 하지만 태스크에 허용된 메모리는 2GiB뿐이어서, 요청을 처리하며 힙과 힙 외 메모리의 실제 사용량이 한도에 닿고 회수도 어려우면 커널의 OOM kill로 종료될 수 있어요. AWS도 ECS의 메모리 초과 종료를 별도로 설명해요.
실제로 확인한 값
당시 수집된 JVM 최대 힙 지표를 뒤늦게 비교하자 예상과 다른 숫자가 나왔어요. 첫 OOM이 발생한 설정에서는 최대 힙이 태스크 한도의 약 122%였고, 태스크 한도를 늘린 뒤 재발한 설정에서는 약 165%였어요. 두 경우 모두 힙 상한만으로 태스크 한도를 넘었어요. 힙 바깥의 metaspace, 스레드 스택, 코드 캐시, 네이티브 메모리는 계산에 넣기도 전이었어요. 종료된 태스크에서는 ECS가 OutOfMemoryError: Container killed due to memory usage와 exit 137을 기록했어요.
호스트가 커졌을 때 최대 힙도 함께 커진 점을 보면 JVM이 태스크 한도보다 큰 값을 기준으로 계산했다는 설명이 실측과 맞아요. JVM이 당시 컨테이너 안에서 정확히 어떤 메모리 값을 읽었는지까지는 확인하지 못했어요.
AWS도 Java 컨테이너 메모리 가이드에서 힙 외 메모리를 위한 여유를 남기고 -Xmx보다 -XX:MaxRAMPercentage를 활용하는 방식을 설명해요. 이 조언이 유효하려면 먼저 JVM이 원하는 컨테이너 메모리 한도를 기준으로 비율을 계산하는지 확인해야 해요. AWS가 제시한 약 75%는 출발점이지, 모든 서비스에 안전한 고정값은 아니에요.
바꾼 것과 다음에 확인할 것
앱 컨테이너의 하드 한도를 명시하고, 태스크 예산 안에서 힙 외 메모리가 사용할 여유를 남기도록 비율을 조정했어요. 배포 후 확인 기록에는 최대 힙이 컨테이너 한도의 50%와 일치한다고 남아 있어요. 이 50%는 당시 서비스에 선택한 값이지 다른 Java 서비스에 그대로 권할 숫자는 아니에요.
이번에 배운 점은 간단해요. 비율을 설정했다는 사실보다, 그 비율이 무엇을 기준으로 계산됐는지 확인해야 해요. 다음 배포에서는 태스크와 컨테이너의 하드 한도를 함께 보고, 실행 중 JVM의 최대 힙이 예상값과 맞는지 대조하려고 해요. 이후 메모리 사용률과 OOM 재발 여부도 따로 관찰해야 하고요.
이후 같은 OOM 문제는 다시 나타나지 않았어요. 이번 경험에서 가장 오래 남은 것은 MaxRAMPercentage 값을 적어 두는 것과 실제 힙 상한을 확인하는 것은 전혀 다른 일이라는 점이에요.